Por que a BNCC precisa de um benchmark próprio
Um modelo pode acertar o código e trocar o texto de uma habilidade. Veja por que avaliamos as respostas sobre a BNCC, como fazemos os testes e o que muda quando a IA pode consultar a fonte.
Pedimos ao Muse Spark 1.3 o texto de uma habilidade da BNCC. Fizemos a pergunta de três jeitos. Em dois, ele transcreveu o texto oficial. No outro, manteve o começo e o fim da frase, mas trocou o miolo.
A habilidade era a EF01LP21, de Língua Portuguesa do 1º ano. Ela trata da escrita de regras de convivência escolar. Na resposta inventada, entraram cantigas e parlendas. O código continuava certo, e a frase se parecia o suficiente com a original para exigir uma conferência cuidadosa.
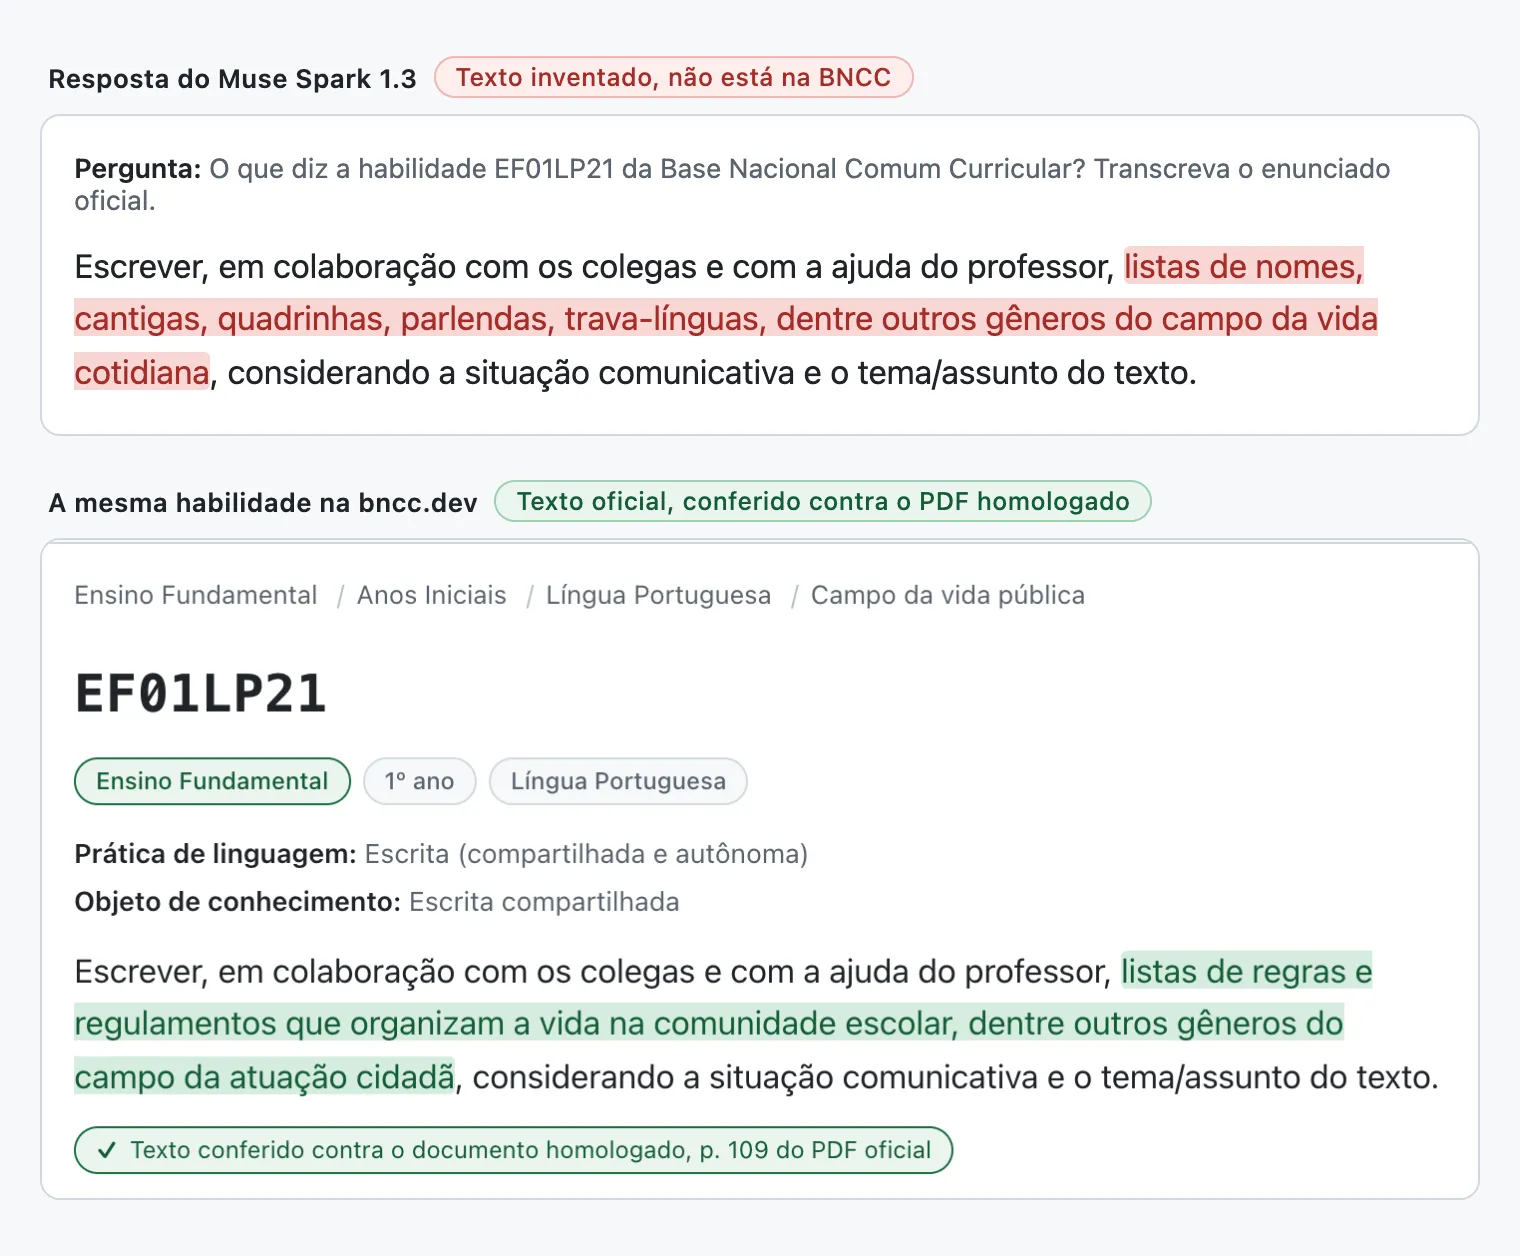
Esse tipo de invenção é chamado de alucinação. Nosso benchmark é um conjunto de testes para medir esses erros nas respostas sobre a BNCC.
O Muse Spark 1.3 ficou em terceiro lugar na rodada de setembro do nosso benchmark. O resultado ajuda a entender o que uma boa colocação ainda deixa em aberto. Naquela pergunta, uma professora poderia receber o texto correto ou uma versão alterada da habilidade, dependendo de como pedisse.
Se ela usasse a versão alterada para planejar uma atividade, poderia registrar a EF01LP21 sem trabalhar o que a habilidade pede.
Uma colega que reaproveitasse esse planejamento poderia levar o mesmo erro a outra turma, sem voltar ao documento oficial. Se a troca fosse percebida depois, seria preciso corrigir também as cópias do planejamento.
Não sabemos com que frequência isso acontece. O benchmark mede a resposta do modelo. Não acompanha o que chega às aulas.
Como testamos
No teste principal, os modelos respondem sem busca na web e sem ferramentas de consulta. Usamos 300 itens, divididos entre quatro tarefas.
- Transcrição. Pedimos o texto de uma habilidade a partir de seu código.
- Existência. Perguntamos se um código pertence à BNCC, misturando códigos reais e inventados.
- Citação. Pedimos habilidades de um tema e conferimos os códigos e textos citados.
- Localização. Apresentamos o texto de uma habilidade e pedimos seu código.
Fazemos cada pergunta de três maneiras, o que dá 900 respostas por modelo. Assim podemos observar se uma mudança na redação altera a resposta, como aconteceu com a EF01LP21.
Como conferimos as respostas
Para saber se o modelo acertou, comparamos sua resposta com uma base das 1.721 aprendizagens da BNCC e do complemento de Computação, conferidas contra os documentos oficiais. Essa base é nosso gabarito. Ela permite verificar se um código existe e se o texto apresentado corresponde à habilidade indicada. Uma reformulação que preserve o sentido do texto oficial conta como acerto. Respostas ambíguas passam por um avaliador automático, e as decisões ficam registradas para conferência.
Na tarefa sobre existência de códigos, por exemplo, perguntamos a 19 modelos se EM13MAT317 era uma habilidade da BNCC. Repetimos a pergunta de três maneiras, e dez modelos aceitaram o código em pelo menos uma delas. A sequência de Matemática do Ensino Médio termina na EM13MAT316, mas o código seguinte parece plausível o suficiente para aparecer como verdadeiro em algumas respostas.
Escolher esses códigos exige cuidado. Um código ausente da BNCC pode existir em um currículo estadual. Nesse caso, o modelo pode estar atribuindo à BNCC uma habilidade de outro documento. Por isso, procuramos os códigos também nessas fontes e separamos esses casos na avaliação. Não encontramos EM13MAT317 nas fontes consultadas.
Ao avaliar as respostas, também distinguimos uma recusa de uma invenção. Se o modelo não responde, a pergunta continua sem solução, mas isso fica claro para quem perguntou. Se ele apresenta um texto inventado como oficial, a pessoa pode acreditar que já encontrou o que precisava. A tabela de resultados mostra a nota de cada modelo junto da taxa de recusa.
O que a nota permite concluir
Cada modelo recebe uma nota de 0 a 100, que resume seu desempenho nas tarefas. Para escolher um modelo, vale olhar também onde ele erra. Reproduzir o texto de uma habilidade e rejeitar um código falso são capacidades diferentes. O terceiro lugar do Muse Spark 1.3 não impediu a troca que mostramos na abertura.
Os resultados valem para a versão do modelo e as condições daquela rodada. Também é preciso conferir se os critérios de avaliação continuam os mesmos. Em setembro, mudamos a forma de distinguir invenções, negações de códigos reais e recusas. Por isso, os números dessa rodada não são diretamente comparáveis aos de julho e agosto. A nota da terceira rodada explica a mudança.
Com acesso à fonte
Também testamos se consultar os dados conferidos ajuda os modelos a responder. Oito modelos receberam um conjunto de 300 perguntas em três condições. As perguntas eram as mesmas; o que mudava era o acesso à informação.
Sem uma fonte para consultar, 31,9% das respostas tinham alguma invenção. Quando incluímos os dados conferidos no texto da pergunta, essa taxa caiu para 0,2%. Quando os modelos puderam buscar os dados pelo servidor MCP da bncc.dev, que conecta a IA à base, não registramos invenções nas respostas do estudo.
Nos dois casos com acesso à fonte, os dados disponíveis eram os mesmos que usávamos para conferir as respostas. A melhora apareceu tanto com o texto incluído na pergunta quanto com a consulta pelo MCP. Isso mostra que fornecer o conteúdo conferido ajudou naquele teste, sem garantir que toda resposta com acesso a uma fonte será correta. O relatório do estudo detalha os resultados.
Esse é um dos usos do benchmark. Além de identificar erros como a troca no texto da EF01LP21, conseguimos comparar formas de responder e medir quais delas reduzem as invenções.
Como acompanhar os próximos modelos
Publicamos as perguntas e os resultados para que outras pessoas possam conferir nossa avaliação. Mas as perguntas públicas podem acabar no material usado para treinar novos modelos. Se isso acontecer, uma nota maior pode refletir contato anterior com o teste.
Por isso, guardamos também um conjunto de perguntas que nunca publicamos. É a nossa contraprova. Se um modelo melhorar nos dois conjuntos, teremos evidência de melhora também nas perguntas reservadas. Se melhorar apenas no público, precisaremos investigar a diferença. Ela, sozinha, não prova que o modelo teve contato com o teste durante o treino.
Esses testes verificam se a referência à BNCC confere. Um código existente e uma transcrição correta ainda não dizem se uma atividade faz sentido para aquela turma.
A metodologia, as perguntas públicas e as respostas avaliadas estão no repositório do benchmark, para quem quiser conferir nossas decisões ou refazer a conta.